Берём на себя работающую систему — свою или чужую. Хорошая поддержка незаметна: о сбое узнаёт наша команда, а не ваши клиенты, а доработки выходят по плану, а не по авралу.
Поддержка нужна не тогда, когда всё сломалось, а когда цена простоя выше цены сопровождения. Достаточно одного признака:
Сбои приходится чинить в авральном режиме, без регламента
Нет согласованных сроков реакции и восстановления (SLA)
Внутренняя команда перегружена и не закрывает все задачи
Нужны доработки и развитие, а не только исправление ошибок
Предыдущая команда ушла, и систему некому поддерживать
Система замедляется из-за роста базы и требует профилактики
«Хорошее сопровождение — это когда о проблеме сначала узнаёт наша команда, а не пользователи.»
Шесть направлений работы. Конкретный набор фиксируется в договоре — под систему и критичность процессов.
Единая точка входа для всех заявок: регистрация, классификация, приоритизация и маршрутизация.
Результат
Ни одно обращение не теряется в переписке — у каждого есть статус, приоритет и срок.
Диагностика и восстановление работы сервиса по регламенту, затем разбор корневой причины.
Результат
Сначала сервис снова работает, потом причина закрывается навсегда — а не до следующего раза.
Новые функции, доработка интерфейсов и улучшения по запросу бизнеса — плановыми релизами.
Результат
Продукт развивается, не превращая каждый релиз в риск для стабильности.
Контроль доступности, ошибок и производительности с оповещением дежурной команды.
Результат
О проблеме первой узнаёт наша команда, а не ваши пользователи.
Работа с ростом базы данных, производительностью, обновлением зависимостей и техдолгом.
Результат
Система не деградирует по мере роста данных и нагрузки.
Аудит кода, инфраструктуры и техдолга, восстановление документации, план стабилизации.
Результат
Понятная картина состояния системы и план: что чинить сразу, что можно отложить.
Три формата под разную критичность и объём задач. Подходящий подбираем после аудита системы.
Для проектов, которые мы разработали, — сразу после запуска.
Условия
Когда задачи возникают нерегулярно и платить за постоянную команду нет смысла.
Условия
Когда система критична для бизнеса и развивается постоянно.
Условия
Шесть этапов от аудита до регулярной работы. До первого инцидента мы уже знаем, как устроена ваша система.
Код, инфраструктура, техдолг и риски
SLA, приоритеты и каналы эскалации
Документация и доступы, разбор архитектуры
Метрики, оповещения и дежурство
Закрываем критичные проблемы из аудита
Инциденты, релизы и отчётность
Качество поддержки должно быть видно в цифрах, а не на словах. Эти показатели попадают в ежемесячный отчёт.
Заступник
Разработали приложение для защиты детей в опасных ситуациях с трансляцией геопозиции и вызовом помощи
Просмотреть проект
Мария
Создали и внедрили мобильное приложение для автоматизации процессов крупнейшей мебельной фабрики России и СНГ
Просмотреть проект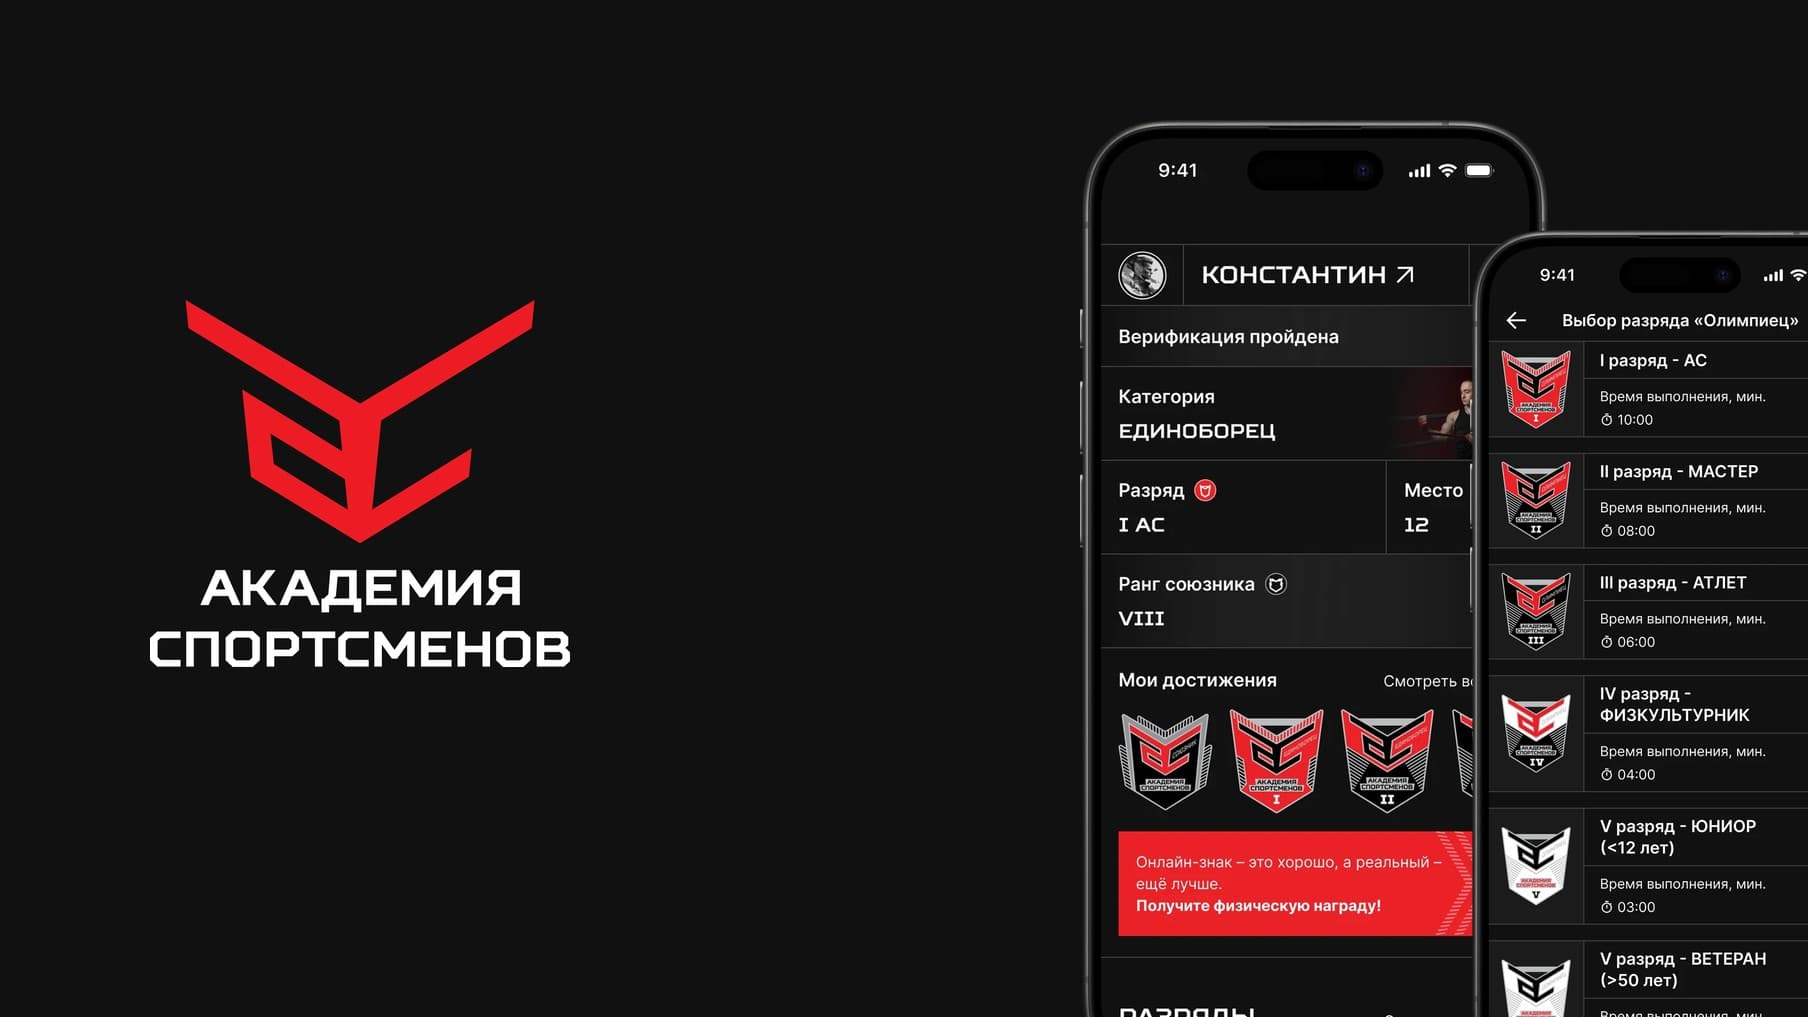
Академия Спортсменов
Мобильное приложение и админ-панель: спортсмен сдаёт разряд по видео и получает награду почтой
Просмотреть проектДа, это заметная часть нашей работы. Начинаем с аудита: смотрим код, инфраструктуру и объём техдолга, восстанавливаем документацию, если её нет. По итогам даём план стабилизации и честно говорим, какие риски есть в текущем состоянии.
Зависит от формата: оплата фактических часов по лимитам или фиксированная абонентская стоимость за квартал либо год. На цену влияют критичность системы, требуемое время реакции и объём доработок. Точную оценку даём после аудита — до него любая цифра была бы выдумкой.
SLA — согласованные сроки реакции и восстановления по каждому типу обращений. Критичный сбой, мешающий работе бизнеса, и мелкое неудобство в интерфейсе получают разные приоритеты и разные сроки. Конкретные значения фиксируем в договоре под критичность ваших процессов.
Нет. Доработки и развитие входят в сопровождение наравне с инцидентами: новые функции, изменения интерфейсов, оптимизация. Именно поэтому мы ведём общий бэклог и планируем релизы, а не только реагируем на поломки.
Передадим код, документацию, доступы и открытый бэклог. Мы изначально ведём проект так, чтобы его можно было передать: без этого поддержка превращается в зависимость от подрядчика.
Да, и лучше до первого инцидента. Аудит показывает, где система уязвима под ростом нагрузки и данных, и позволяет назвать реалистичный SLA. Принимать на поддержку систему, устройство которой мы не знаем, нечестно по отношению к вам.
Расскажите, что за система и что с ней сейчас происходит. Предложим формат и объём аудита.